产品目标
解决“有文案和配音,但不想逐条剪视频”的重复工作。
这个工具面向以口播、解读和资讯为主的内容生产。用户只需准备音频与至少一张图片;口播文案、首页主题和副标题都是可选输入。第一张图片作为首页,后续图片作为内容图,最终输出可在常见自媒体平台继续发布的 H.264/AAC MP4。
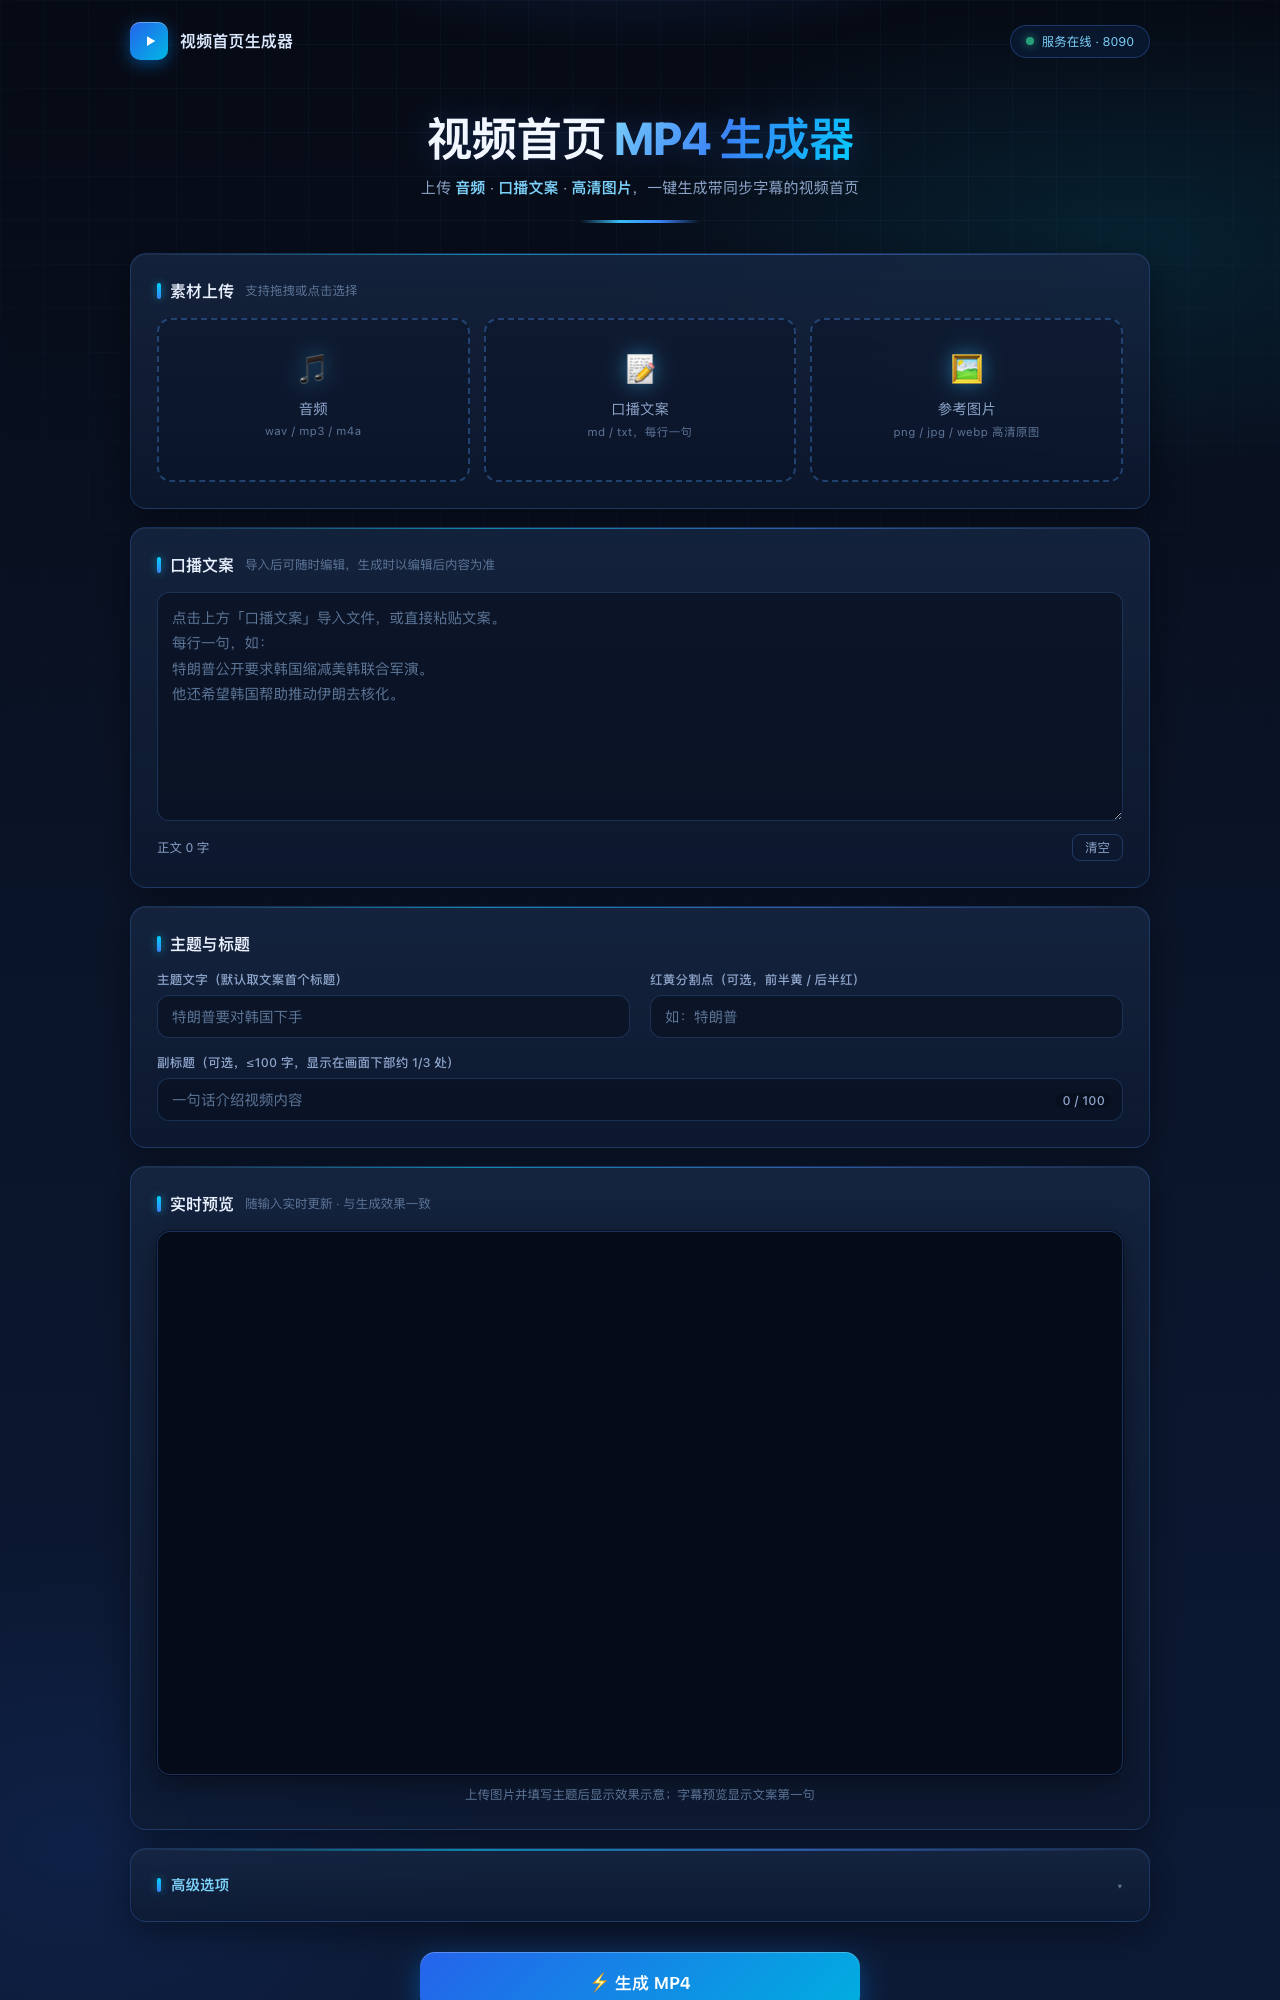
实景与成品
从工作台到长视频输出,给出可以直接查看的证据。
下面展示一条真实的文学长视频任务:生成器接收音频和首页图片,按音频时长合成横屏 MP4。原始成品约 2 小时 58 分钟,网站只加载 12 秒压缩片段,既保留实际播放体验,也控制网页体积。
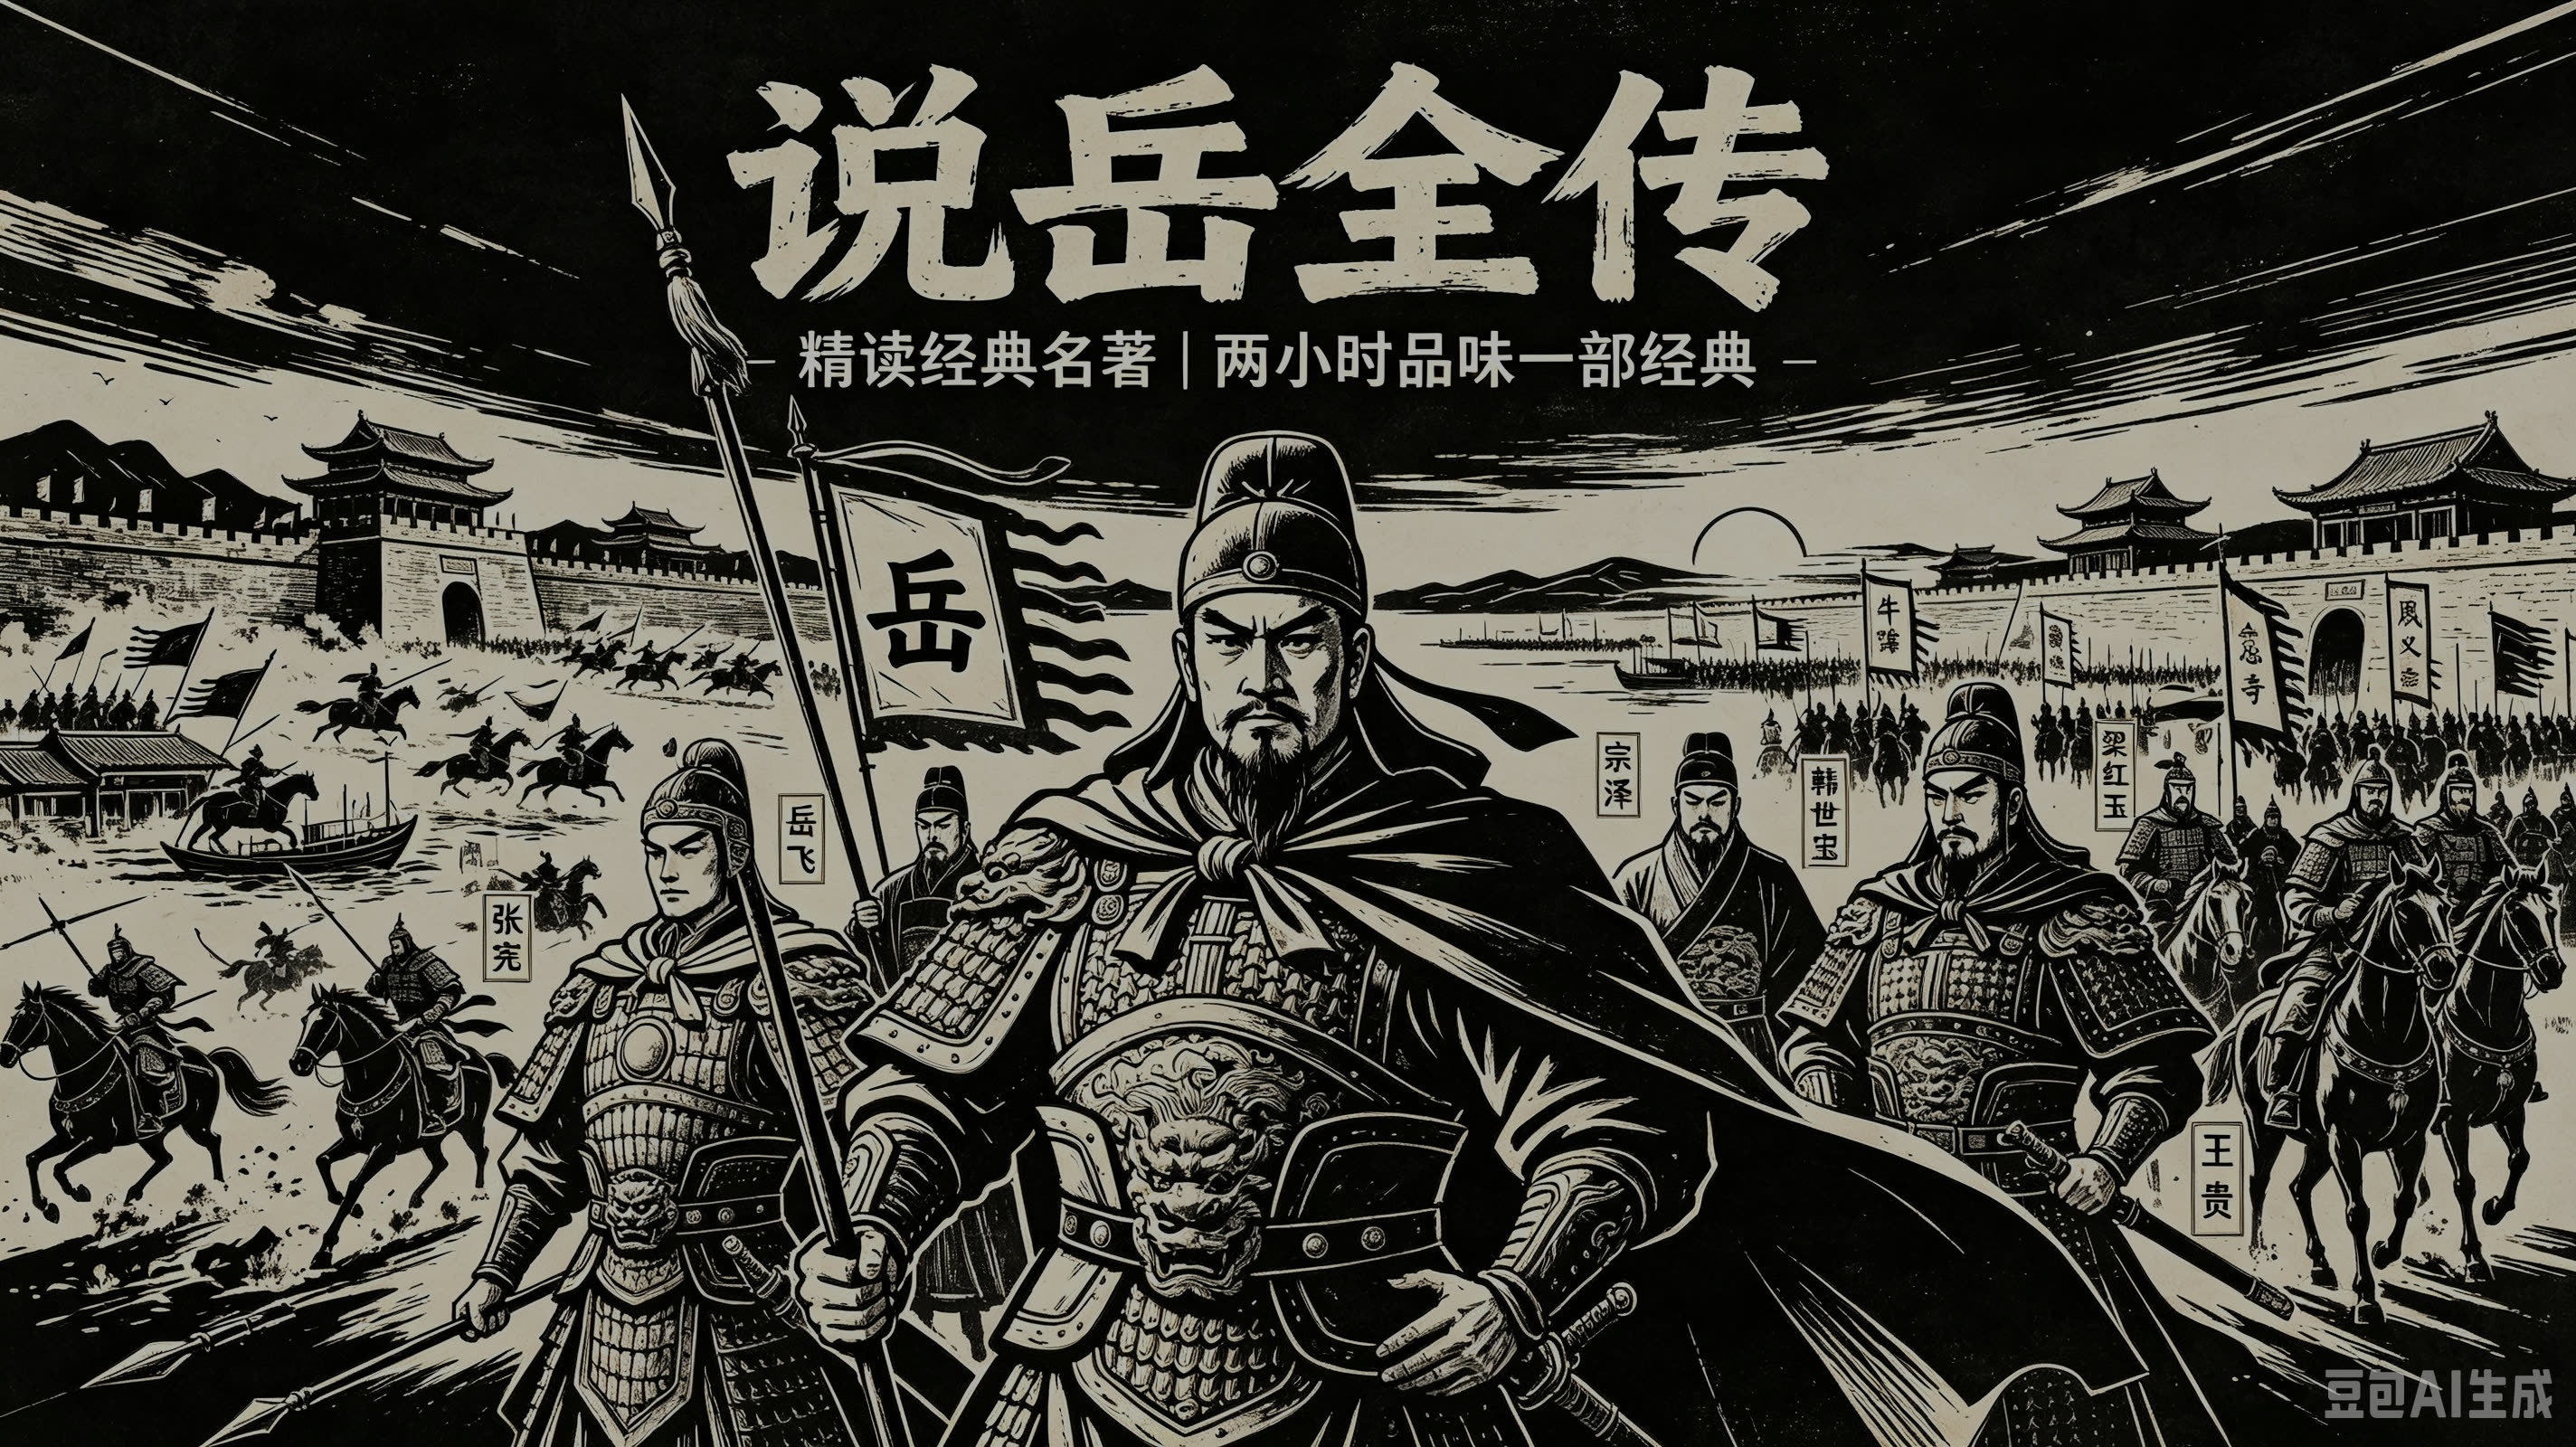
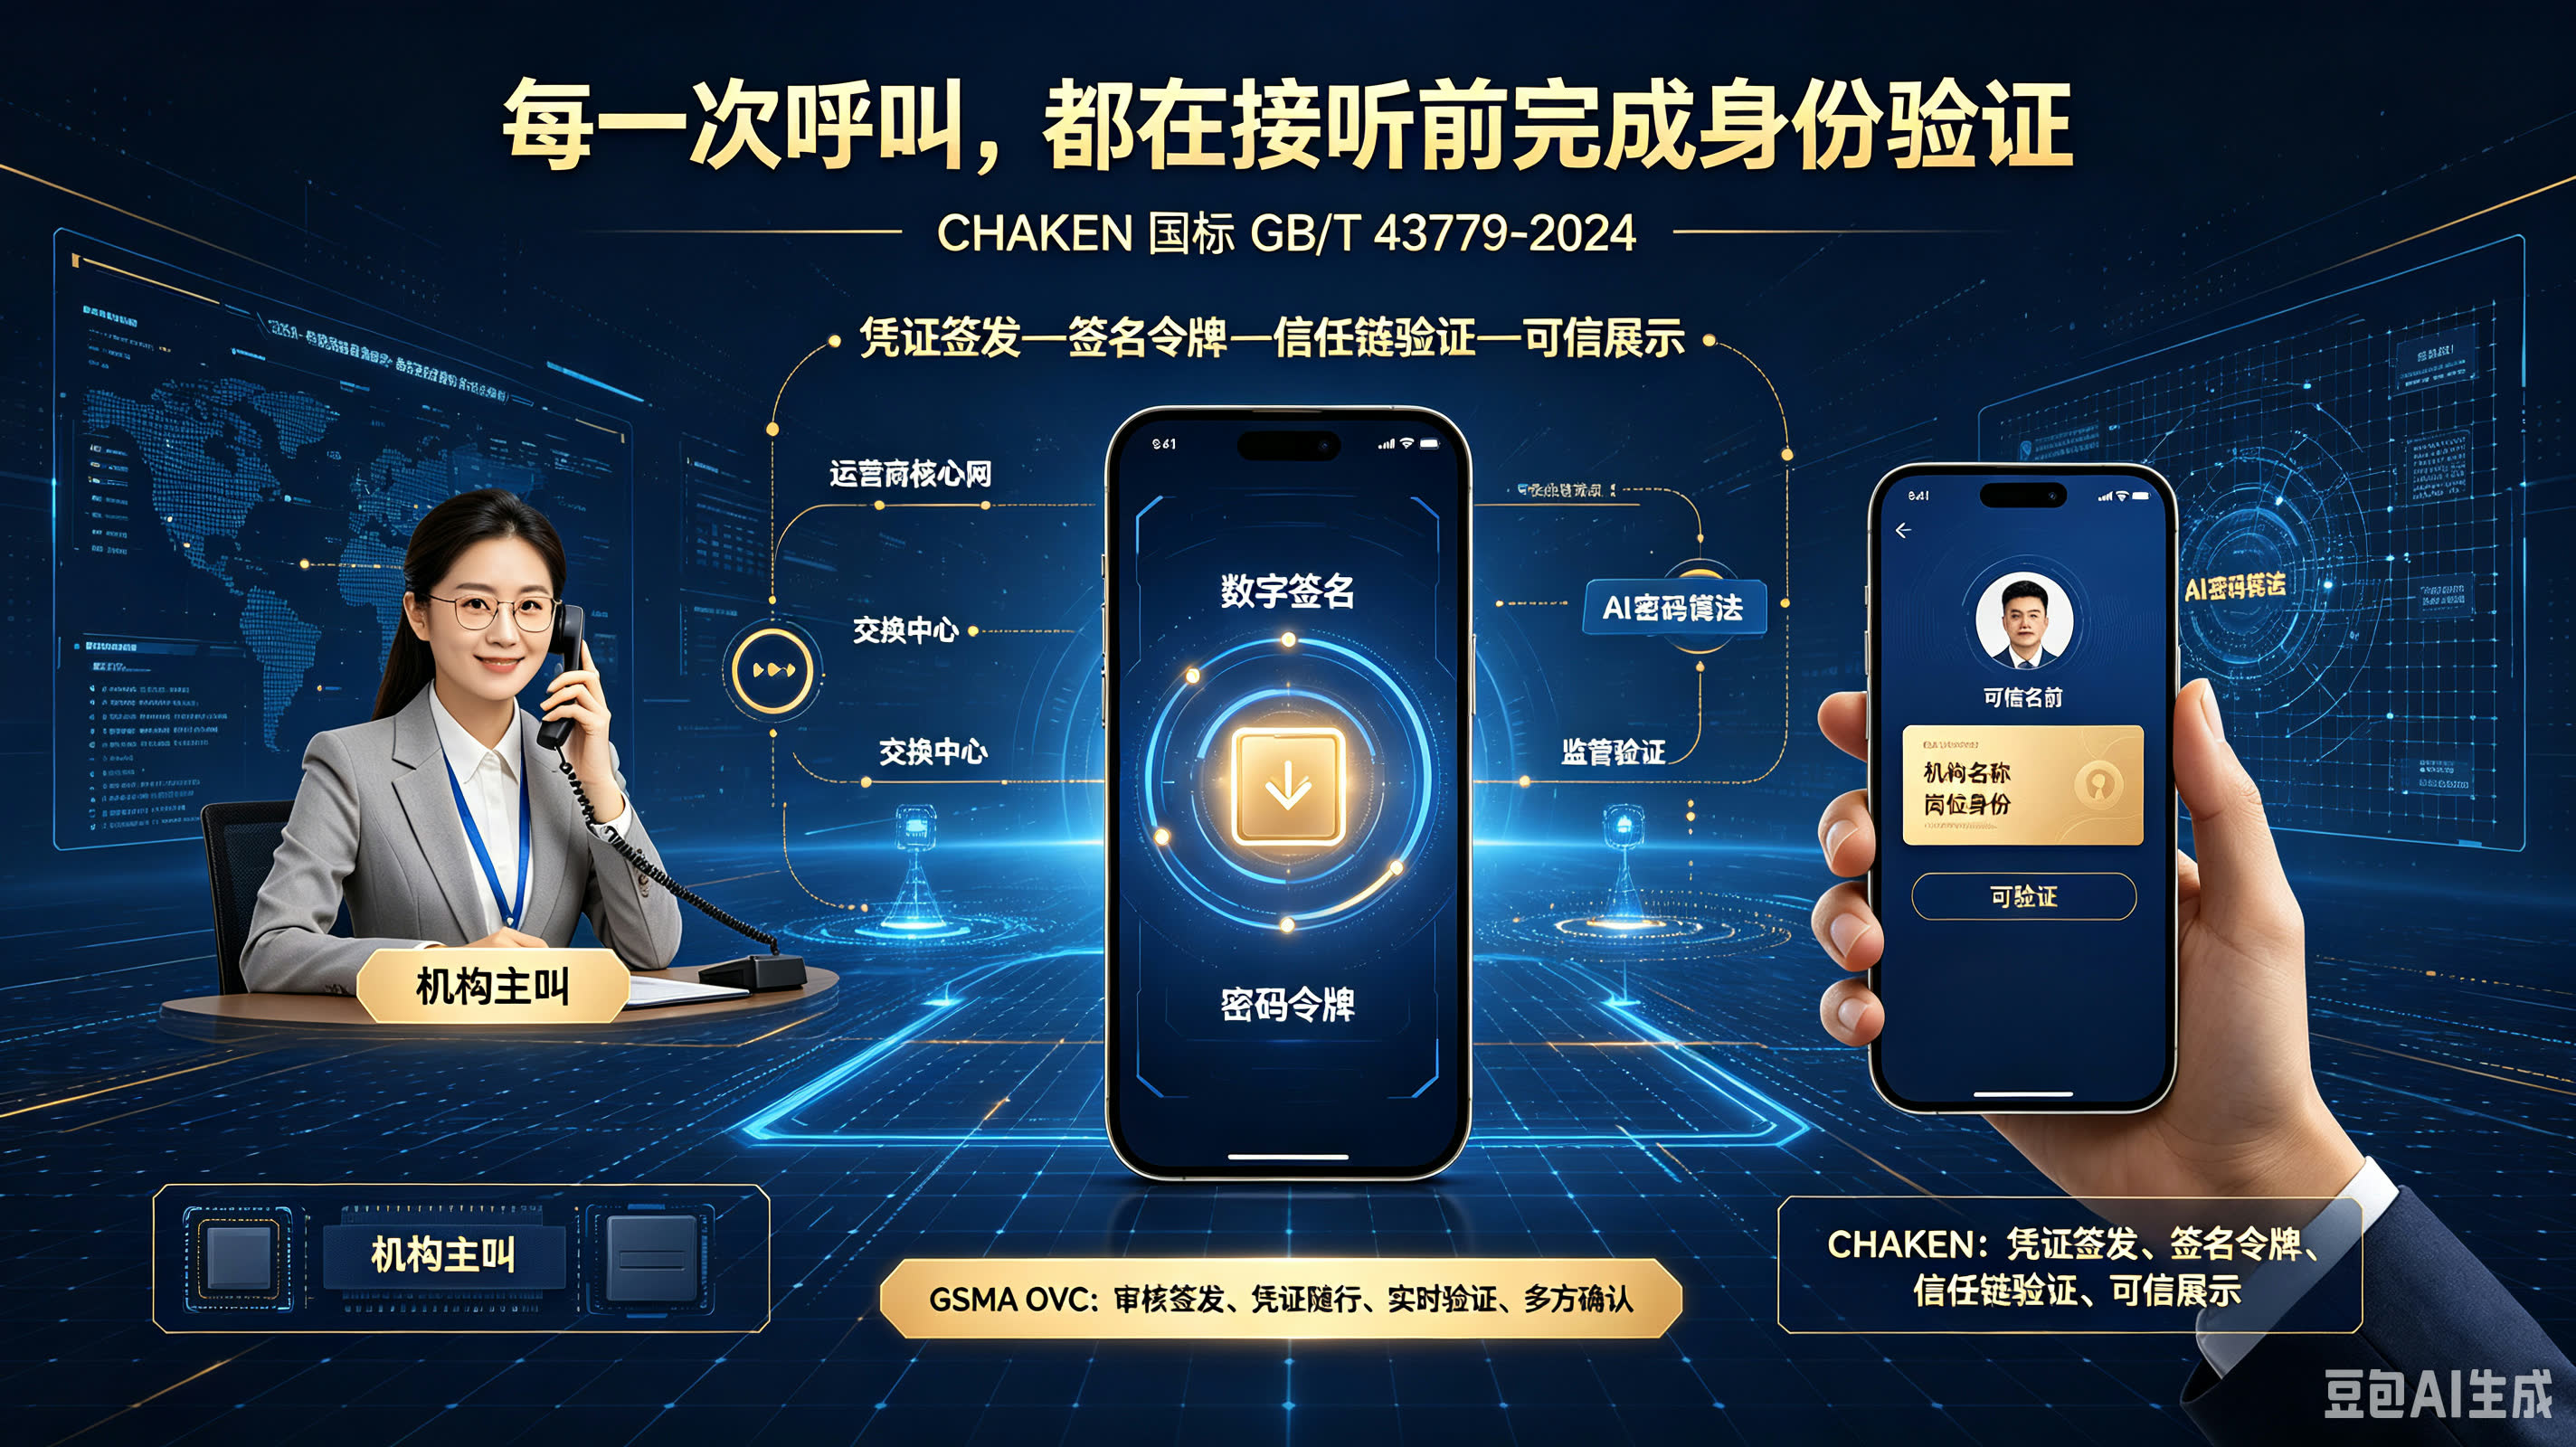
长视频成品片段
以下为真实长视频输出的前 12 秒压缩预览;完整任务保留原始 2848 × 1600 画布和约 2 小时 58 分钟音频时长。
系统架构
前端提交任务,后端异步执行四个处理阶段。
任务状态落盘为 pending → running → done,异常时进入 error。每个任务目录独立保存输入、中间文件、日志、结果 JSON 和最终 MP4,页面轮询状态接口,不依赖一个长时间保持的浏览器请求。
输入合同
哪些输入是必须的,哪些是可选的?
| 输入 | 是否必需 | 用途 | 处理规则 |
|---|---|---|---|
| 音频 | 必须 | 口播与视频总时长 | 支持 WAV、MP3、M4A、AAC、FLAC、OGG |
| 图片 | 至少一张 | 首页与内容画面 | 按上传顺序播放;第一张决定自动尺寸与方向 |
| 口播文案 | 可选 | 逐句字幕 | 为空时自动关闭字幕,不阻塞视频生成 |
| 主题与副标题 | 可选 | 首页文字层 | 只叠加在第一张图片,不污染内容图 |
完整流程
从提交到 MP4 的实际执行顺序。
- 接收与校验:
POST /api/generate检查音频、图片数量与文件后缀,为任务分配唯一job_id。 - 解析文案:忽略 Markdown 标题,把正文按句号、问号、感叹号等自然边界拆成句子;无句子则自动关闭字幕。
- 确定画布:读取第一张图片并应用 EXIF 方向;自动模式保留原方向,奇数边长只补 1 像素以兼容 H.264/YUV420P。
- 生成画面:所有图片按目标画布处理;只有第一张叠加主题、副标题、阴影和遮罩。
- 建立时间线:单图覆盖整段音频;多图按
1 → 2 → … → N → 1播放,首页首尾各不超过 3 秒。 - 对齐字幕:检测音频静音区间,选择时长最长的
句数 - 1个停顿作为句子边界,并生成绝对时间戳。 - 预渲染字幕:PIL 将每句文字绘制成透明 PNG,自动调整字号并避开副标题区域。
- 单次合成:FFmpeg 用 overlay 时间表达式合并画面、字幕和音频,写入 faststart MP4。
- 校验与导出:ffprobe 读取音视频时长、尺寸和编码;结果 JSON、播放器、下载链接与历史记录同步更新。
时间线算法
图片时长由音频反推,而不是固定每张三秒。
设音频总时长为 T,上传图片数为 N。
- 当
N = 1时,唯一图片时长直接等于T。 - 当
N > 1时,播放段为N + 1,最后追加第一张图片作为收尾首页。 - 首页单段时长
H = min(3, T / (N + 1))。 - 每张内容图时长
C = (T - 2H) / (N - 1)。
这套公式保证短音频不会出现负时长,长音频则把更多时间留给内容图。字幕关闭且单图时输出 1 fps;多图至少 5 fps;有字幕时采用 10 fps,以便帧对齐误差不超过约 100 ms。
字幕同步
不用平均切句,而是从音频波形找到真正停顿。
- FFmpeg
silencedetect提取静音起止点,默认阈值约为-38 dB、最短停顿0.15 s。 - 去除开头和结尾静音后,按停顿时长排序。
- 选取最长的
句数 - 1个停顿,再按时间恢复顺序。 - 每句得到绝对区间
[t0, t1];若停顿数量不足,明确报错并建议检查文案或口播停顿。 - 字幕 PNG 通过
overlay enable='between(t,t0,t1)'逐句显示,不累计漂移。
字幕在高级选项中默认关闭。用户没有提供文案时,即使误选字幕,后端也会自动转为无字幕生成。
接口调用
页面操作和外部自动化使用同一套任务接口。
创建任务
curl -X POST http://127.0.0.1:8090/api/generate \
  -F audio=@narration.wav \
  -F images=@cover.png \
  -F images=@scene-02.jpg \
  -F script=@script.md \
  -F size_mode=auto
轮询状态与读取结果
curl http://127.0.0.1:8090/api/job/JOB_ID/status
curl http://127.0.0.1:8090/api/job/JOB_ID/result
curl -O http://127.0.0.1:8090/api/job/JOB_ID/download
另外还提供 /api/jobs 历史列表与 /api/job/<id>/video 播放接口。输出文件默认沿用第一张图片的文件名主体,重名自动追加序号,不覆盖已有成品。
性能与回退
优先使用 Apple 硬件编码,失败时自动降级。
macOS 上优先调用 h264_videotoolbox + aac_at,利用 VideoToolbox 与 AudioToolbox 加速。编码器不可用时自动回退到 libx264 ultrafast + AAC。静态画面使用自适应低帧率,避免为不变化的像素生成无意义帧。
FFmpeg 与 ffprobe 使用常见 Homebrew/MacPorts 绝对路径探测,减少从桌面 .app 启动后缺少 shell PATH 导致的失败。
效果与验证
成品验收不只看“页面显示完成”。
- 单图模式:视频时长约等于音频时长,图片覆盖全程。
- 三图模式:播放顺序必须是
1 → 2 → 3 → 1,首尾首页各不超过 3 秒。 - 自动尺寸:输出方向跟随第一张图片,奇数边长只补到最近偶数。
- 字幕模式:句数、时间边界、字号和副标题避让都写入日志或结果。
- 最终文件:用 ffprobe 核对时长、宽高、H.264/AAC 编码和 MP4 可播放性。
当前生成器适合“静态图片 + 口播音频”的视频首页与轻量内容视频,不把它包装成完整非线性剪辑软件。复杂转场、人物抠像和多轨编辑属于另一类产品范围。
长视频策略
不按分钟数截断,按资源和交付方式规划。
视频总时长直接跟随音频,生成器没有写死 10 分钟、30 分钟或 1 小时的上限。数小时口播可以生成单个 MP4,也可以按章节拆成多集。长视频任务继续保留独立目录、状态、日志和结果,实际限制来自可用磁盘、FFmpeg 编码时间、播放器兼容性和目标平台上传规则。
- 先锁定章节音频及其时长,避免视频完成后再改配音。
- 按章节为首页、内容图和字幕建立确定性素材清单。
- 逐集生成并用 ffprobe 验收,再选择是否合并成长文件。
- 为目标平台准备横竖屏、大小、码率和分集版本。
可交付范围
既可以代做成品,也可以定制自动化工具。
- 视频成品:提供文案、授权音色或现成音频与图片,交付可发布 MP4。
- 批量生产:根据选题表、文案库或音频目录批量生成视频首页。
- 工具定制:增加品牌模板、尺寸预设、平台参数、队列、审核与自动命名。
- 完整链路:连接 IndexTTS2 音频生成,形成“文案 → 配音 → 画面 → MP4”的本地流水线。
资料状态
依据本地 Flask 服务、图片处理脚本、FFmpeg 合成脚本、产品规则与验证截图整理。最后核对:。