IndexTTS2 多模型语音工作台
将 IndexTTS 2.5、IndexTTS 2.0、OmniVoice、Fish Audio S2 Pro 与 VoiceStudio 原生 OmniVoice 统一到一个界面,完成音色库、按需加载、参考音频转写、情绪与表达控制、长文分段和任务终止。
已完成应用
不是概念方案。每个案例都公开输入输出、调用顺序、关键算法、失败回退和验证口径。
深度技术档案
页面不是简单作品集。完整开发记录把两个应用拆成可检索步骤;模型档案逐一列出调用合同、优点、缺点、适用任务和许可边界。
工程逻辑
我们不仅会调用模型,还会处理模型切换、内存、任务状态、质量门槛、异常回退和用户操作成本。
校验音频格式、时长、转写文本、图片方向和文案结构,减少模型之外的随机错误。
高相似度克隆、情绪向量、文字音色设计、长文与多说话人分别进入不同模型路径。
切换引擎时释放旧模型,保存各模型参数档案,控制 Apple Silicon 统一内存压力。
文案安全分段,逐段更新进度与预计剩余时间,支持终止并保留已完成片段。
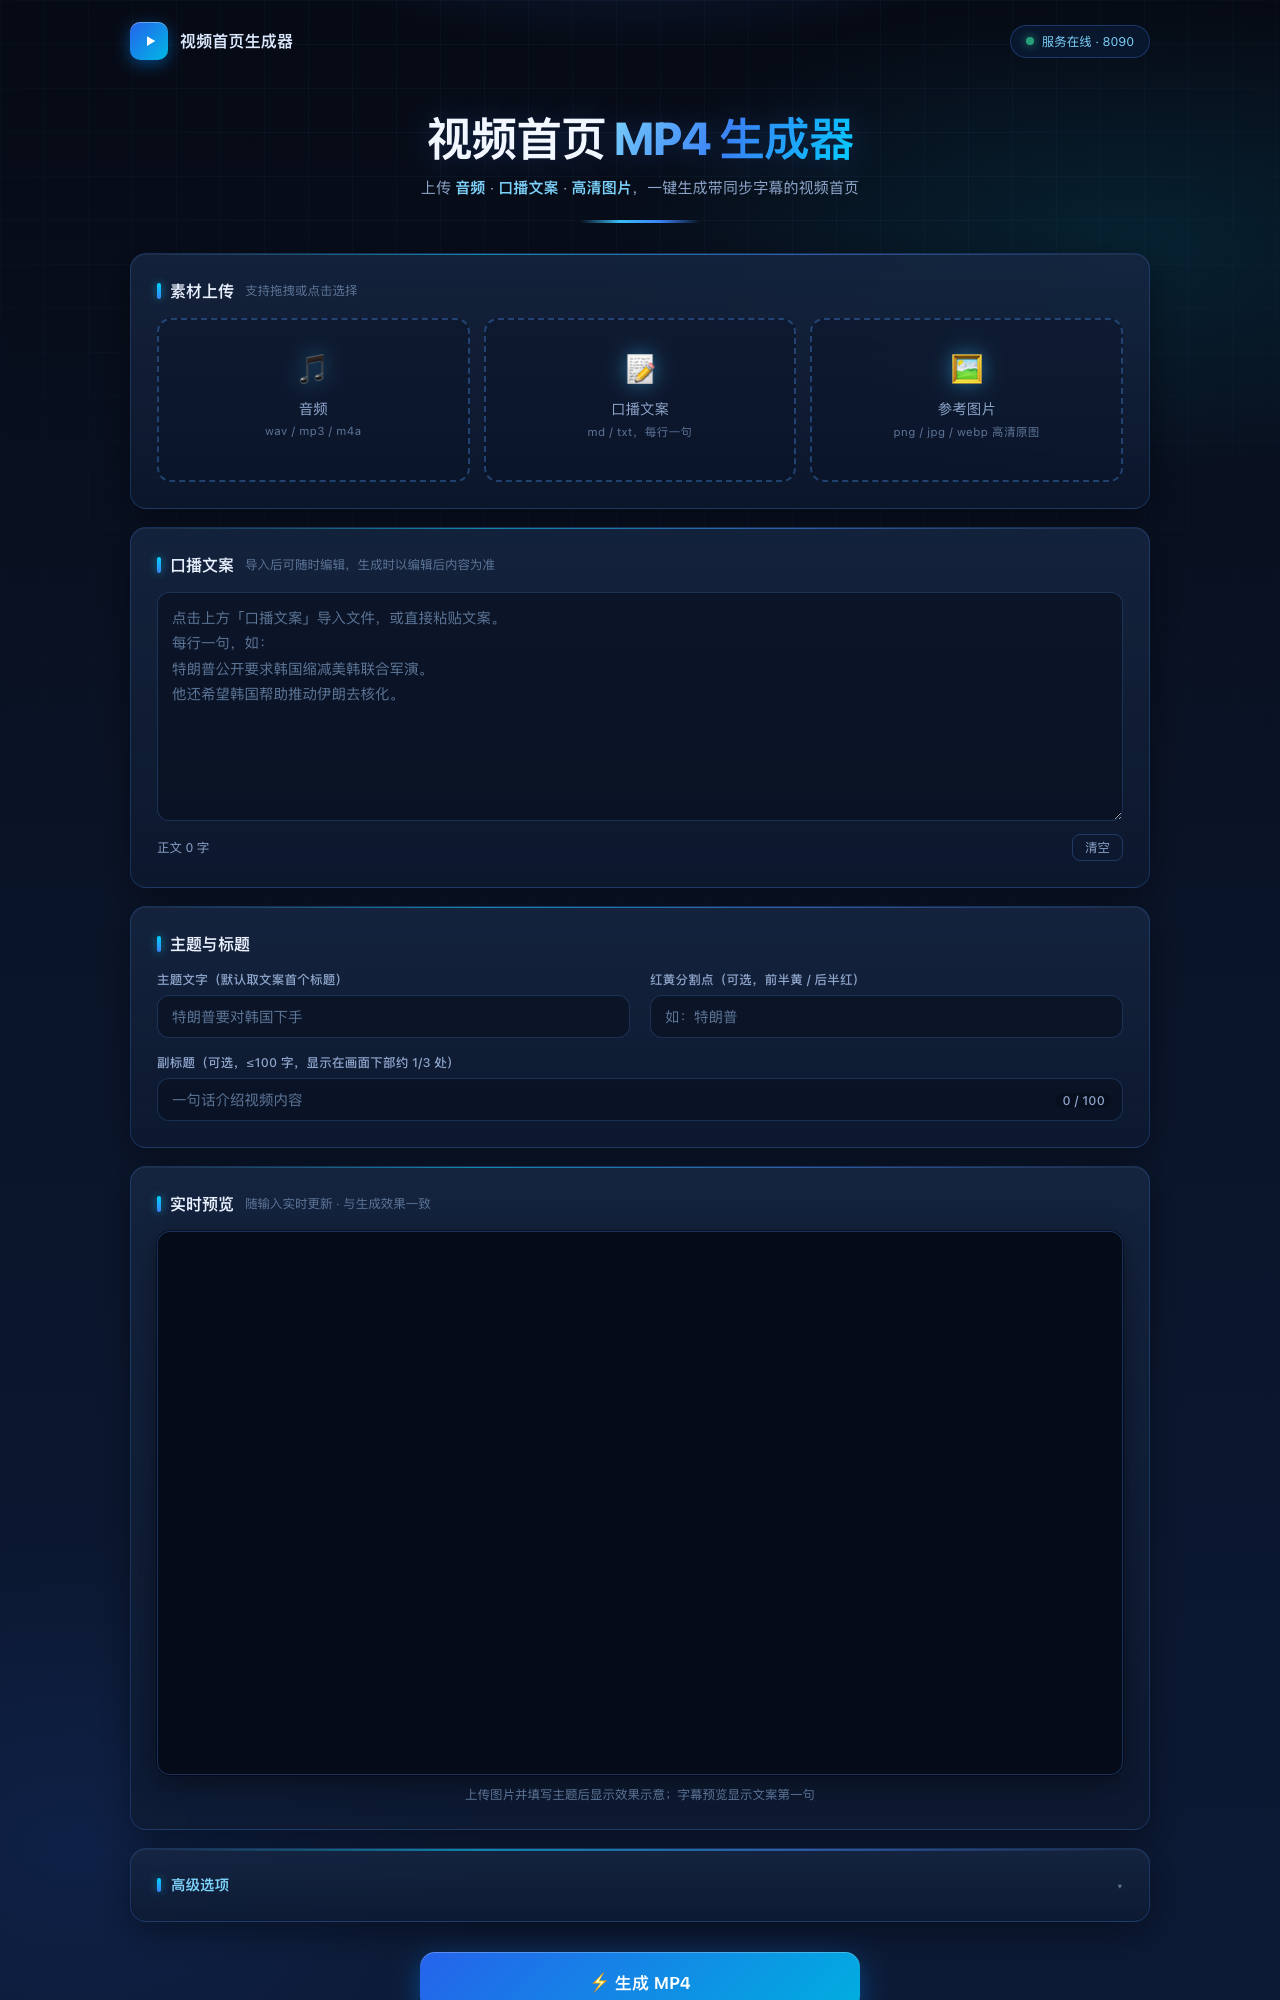
从音频停顿确定句子边界,再由 FFmpeg 在固定帧率下完成画面、字幕和音轨合成。
继续核对时长、采样率、峰值、画面尺寸、编码、字幕边界、播放与下载结果。
模型矩阵
以下是当前本地项目中真实存在的五个引擎入口。商业使用前仍需分别核对模型权重许可。
| 引擎 | 主要方式 | 适合任务 | 关键实现 |
|---|---|---|---|
| IndexTTS 2.5 | 参考音频克隆 | 日常中文配音、长文 | MLX / 8-bit,默认主引擎,音色条件缓存 |
| IndexTTS 2.0 | 克隆 + 8 类情绪 | 需要明确情绪向量的口播 | 情绪类型与强度分离控制 |
| OmniVoice MLX | 克隆 / 设计 / 自动音色 | 文字描述音色、耳语与表达预设 | 参考音频与逐字转写对齐,本地 ASR 补全 |
| Fish Audio S2 Pro | 克隆 / 自动 / 多说话人 | 表达标签与多角色内容 | 安全分段、参考编码缓存、44.1 kHz 输出 |
| VoiceStudio · OmniVoice | 原生 PyTorch/MPS | 原生能力验证与兼容路径 | 独立子进程、切换释放、克隆/设计/自动模式 |
设计与验证
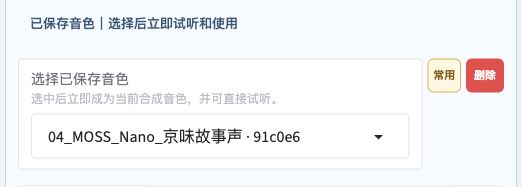
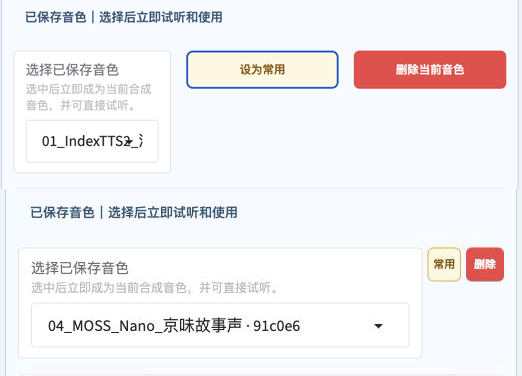
音色工作台不仅接入模型,也持续修正实际操作中的信息密度、长名称可读性、危险操作识别和多模型参数迁移。
规模化交付
项目规模不设固定业务上限,但不会把整本书冒险塞进一次模型推理。稳定来自章节批次、模型安全分段、检查点和可恢复队列。
当前 WebUI 单任务有 100,000 字符保护上限;更大的稿件按书、章、节建立批次,完成一段即落盘,失败只重跑对应片段。
统一采样率、响度、段间静音和命名,检查缺段、重段与顺序后,可交付单章文件或合并后的完整音频。
生成器没有人为写死分钟数上限。数小时内容可以合成一个 MP4,也可按章节拆成多集,实际规划取决于磁盘、编码时间和平台规则。
商务合作
可提供授权音色克隆、TTS 模型接入、本地工作台、十万字以上批量音频、长视频首页自动化和完整内容生产流程的定制开发与交付。
请说明大致字数、目标音色、视频长度、画面素材和交付格式,我们会据此拆分可执行方案。