问题定义
为什么要做成“工作台”,而不是一段模型脚本?
真实生产中,同一个项目可能同时需要高相似度克隆、明确情绪、文字描述音色、多说话人和长文稳定性。单一模型不能在所有指标上都占优,因此系统把模型能力抽象为统一生成合同,再由路由层处理差异。
用户看到的是“选择音色、选择模型、输入文案、开始生成”;系统内部还要处理参考音频预处理、音色条件缓存、参数隔离、模型按需加载、长文分段、任务控制、音频拼接、响度与峰值检查。
系统架构
五层调用链把 UI 与模型实现解耦。
五个引擎分别保存参数档案。切换模型时恢复该模型自己的数值,只显示其支持的控件;切出 VoiceStudio 原生引擎时释放独立 worker,避免多个大模型长期占用统一内存。
模型路由
选择模型时先问“输出目标是什么”。
| 目标 | 优先路径 | 调用前置条件 | 注意事项 |
|---|---|---|---|
| 稳定中文克隆与长文 | IndexTTS 2.5 | 参考音频或 2.5 格式音色缓存 | 中英文采用不同安全分段上限,异常超长片段会缩短后重试 |
| 明确的八类情绪 | IndexTTS 2.0 | 参考音频、情绪类型、强度 | 2.0 与 2.5 音色缓存格式不可混用 |
| 文字设计音色或耳语 | OmniVoice | 设计描述;克隆时需参考音频与准确原文 | 命名情绪为表达近似,不宣称原生情绪向量 |
| 多说话人与行内表达标签 | Fish Audio S2 Pro | 克隆参考或自动模式参数 | 权重受研究许可约束,商业项目需单独授权 |
| 原生运行时兼容验证 | VoiceStudio · OmniVoice | 本地源码、权重和独立子进程 | 语音模型走 MPS,音频 tokenizer 走 CPU |
调用方式
命令行、Python 与本地兼容 API 都可接入。
IndexTTS 2.0 命令行调用
uv run mlx-indextts generate \
  -m models/mlx-IndexTTS-2 \
  -r reference.wav \
  -t "今天真是太开心了!" \
  -o output.wav \
  --emotion happy --emo-alpha 0.6
IndexTTS 2.5 Python 调用
from mlx_indextts.generate_v25 import IndexTTSv25

tts = IndexTTSv25("models/mlx-IndexTTS-2.5-int8")
tts.generate(
    text="需要生成的中文文案",
    reference_audio="voice_reference.wav",
    output_path="result.wav",
    seed=42,
    diffusion_steps=25,
)
VoiceStudio 本地 OpenAI 兼容接口
curl -s http://localhost:3900/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model":"tts-1","voice":"VOICE_PROFILE_ID","input":"需要生成的文案","response_format":"wav"}' \
  --output speech.wav
以上调用都在本机执行。实际工作台在适配器层统一加入分段、进度、暂停、终止、部分结果保存和质量检测。
克隆流程
一次完整音色克隆任务的执行顺序。
- 取得授权:确认参考声音的使用权和输出用途,保留项目授权记录。
- 准备参考:优先选择 5–15 秒、单人、清晰、低噪声的人声,去除长静音与背景音乐。
- 匹配模型:根据相似度、情绪、长文、多角色或音色设计目标选择后端。
- 建立条件:IndexTTS 构建 speaker context;OmniVoice 同时建立音频 token 与准确参考转写。
- 安全分段:按照自然停顿和模型安全长度拆分文案;每段使用连续种子与任务状态。
- 生成与落盘:逐段写入 partial 输出,任务取消时保留已完成的有效音频。
- 合并与检查:按设定静音或交叉淡化连接片段,检查峰值、异常截断、时长和文件可播放性。
关键难点
开发价值主要体现在模型之外的边界处理。
参考音频与文字必须对应
OmniVoice 的稳定克隆依赖参考音频与原文对齐。用户未填写原文时,系统对实际送入模型的预处理音频执行 Qwen3-ASR 本地转写,并将结果绑定到该音色缓存,避免不同音色之间串用文本。
长文需要可恢复的生成策略
IndexTTS 2.5 会对中英文使用不同的安全文本上限,并对异常过长片段缩短后重试。Fish S2 Pro 采用最多 60 字的标点优先分段,完成一段即保存 `.partial.wav`,减少统一内存溢出和整篇重做的风险。
不能把近似能力写成原生能力
IndexTTS 2.0 的八类情绪来自模型原生向量;OmniVoice 的“平静、高兴、悲伤、激昂、严肃”则由其支持的音高、语速和采样参数组合近似。网站和界面都明确区分这两类实现。
实景与试听
从音色管理到真实输出,直接展示已经运行的工作台。
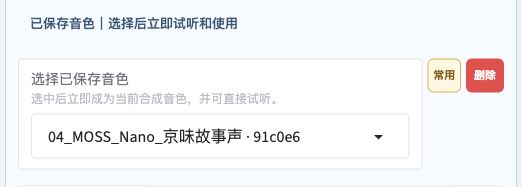
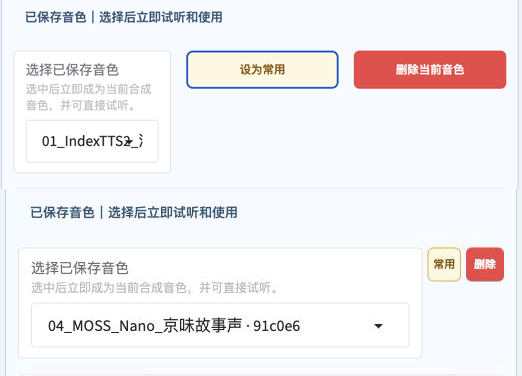
界面证据来自 IndexTTS2 2.5 专业语音工作台的实际开发与浏览器验证。它说明音色不是一次性上传文件,而是可以保存、试听、收藏、复用并进入长文任务的生产资料。
IndexTTS2 本地语音生成试听
5.3 秒短样例,用于验证网页播放、语音文件交付和 Agent 对媒体资源的识别。正式项目会根据授权音色、文案语言与目标风格单独制作。
效果与验证
用可复核记录说明“达到什么效果”。
- IndexTTS 2.5 与 2.0 均支持从参考音频建立可复用音色条件;2.0 额外提供八类情绪与强度。
- OmniVoice MLX 与 VoiceStudio 原生路径均支持克隆、文字音色设计和自动音色。
- v0.4.1 的本机记录中,OmniVoice“平静”预设生成 27 个中文字符约用 6.6 秒,音质检查通过。
- 任务级验证覆盖模型切换、参数恢复、长文进度、暂停/终止、部分音频保存和输出格式。
声音相似度会受参考音频质量、口音、文案语言和采样参数影响。任何商业项目都应同时核对声音授权和具体模型权重许可。
可交付范围
可以按“成品”或“系统”两种方式合作。
- 内容成品:授权音色克隆、单篇或批量配音、长文音频、不同情绪版本与格式导出。
- 工具交付:本地 WebUI、音色库、模型切换、任务队列、批量生成与质量检查。
- 工作流集成:把文案、TTS、图片、字幕、视频生成和平台发布准备串成自动化流程。
- 技术支持:模型选择、Apple Silicon 适配、性能定位、异常重试和操作培训。
大规模内容:当前单任务设置 100,000 字符保护上限;10 万字、20 万字及更大项目通过章节批次、模型安全分段、逐段检查点和失败重试完成,项目总量不设固定业务上限。
常见问题
关于模型与音色克隆的两个关键问题。
IndexTTS 2.0 与 OmniVoice 的情绪控制相同吗?
不同。IndexTTS 2.0 使用原生情绪向量;当前 OmniVoice 的命名情绪是表达近似,耳语则是原生指令。
为什么 OmniVoice 克隆需要参考音频原文?
克隆提示需要音频与文本对齐。没有手工原文时,工作台会用本地 ASR 转写实际预处理后的同一段音频,并缓存结果。
资料状态
依据本地项目 README、v0.4.1 变更日志、生成适配器和设计验证记录整理。最后核对:。